
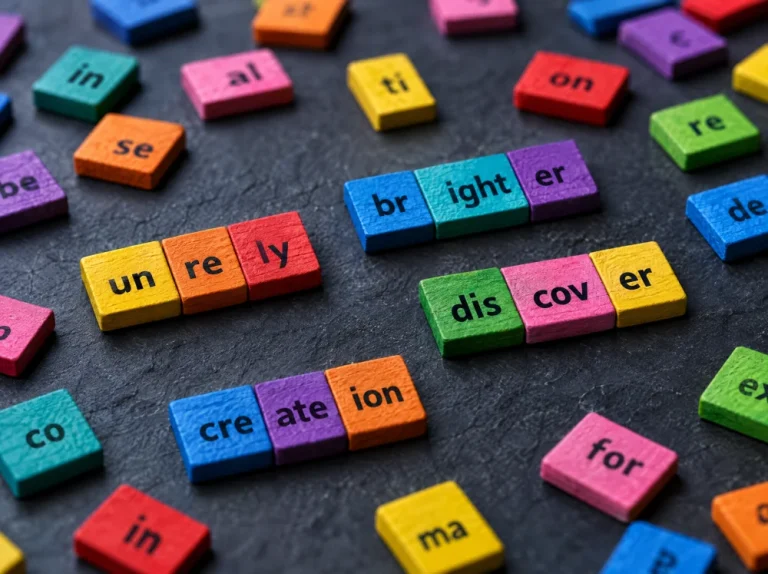
Yapay zeka ile konuşmaya başladığınızda “merhaba” yazmanız yetiyor gibi görünür. Ama model o kelimeyi sizin gibi okumaz. Onun gördüğü şey bir dizi sayıdır. Bu sayıların her birine token denir. Token nedir sorusunun cevabı, yapay zekânın metni nasıl işlediğinin temelini oluşturur.
Yapay zeka eğitiminde ilerlemek isteyenlerin en sık takıldığı konulardan biri de tam olarak budur. Token mantığını anladığınızda hem daha iyi prompt yazabilir hem de modelin neden bazen konuşmanın başını unuttuğunu veya Türkçe metinlerin neden bazen daha pahalıya geldiğini rahatça kavrarsınız.
Token Nedir? Yapay Zeka Metni Nasıl Parçalar?
Bir dil modeline cümle yazdığınızda önce metin küçük parçalara bölünür. Bu parçalar bazen tam bir kelime, bazen bir hece, bazen de sadece bir ek olur. Token nedir diye sorulduğunda en kısa cevap bu parçalardır: modelin işlediği en küçük metin birimi.
Örneğin “evlerimizden” kelimesi, kullanılan tokenizer’a bağlı olarak “ev”, “ler”, “imiz”, “den” gibi parçalara ayrılabilir. Bu yalnızca anlatım için bir örnektir; gerçek bölünme her modelin kendi tokenizer’ına göre değişir. Model kelimelerle değil, bu parçalara karşılık gelen sayılarla çalışır. Aynı parça her seferinde aynı numarayı alır.
Yapay zeka eğitiminde bu ayrımın önemli olmasının nedeni şudur: modelin “gördüğü” şey kelimenin kendisi değil, o kelimenin parçalarına verilen sayılardır. Bu yüzden harf sayma, kelime sayma veya çok uzun ekli kelimelerde beklenmedik sonuçlar çıkabilir.
Neden Subword Tokenizasyon Kullanılıyor?
Günümüzdeki dil modellerinin birçoğu alt kelime (subword) tokenizasyonu kullanır. En yaygın yöntemlerden biri Byte Pair Encoding (BPE) yöntemidir. Sistem, eğitim verisinde en sık yan yana gelen parçaları bulur ve birleştirerek yeni token’lar oluşturur. Sık kullanılan kelimeler tek token olarak kalırken, nadir veya karmaşık kelimeler daha küçük parçalara bölünür.
OpenAI’ın açık kaynak tiktoken kütüphanesi kendini OpenAI modelleri için hızlı bir BPE tokenizer olarak tanımlıyor. Kütüphanede o200k_base ve cl100k_base gibi farklı kodlamalar bulunuyor. Sözlük boyutu ve bölme biçimi modele göre değişir. Claude, Gemini ve diğer modeller de kendi tokenizer’larını kullanır; bu yüzden aynı metin farklı modellerde farklı sayıda token tutabilir.
Token nedir sorusuna alt kelime yaklaşımının avantajı şudur: sözlük şişmez ve model daha önce görmediği kelimeleri tamamen “bilinmeyen” olarak bırakmaz. Token nedir sorusunu anlamak, bu yüzden model davranışlarını daha doğru yorumlamanın ilk adımıdır.
Türkçe Neden Daha Fazla Token Harcayabilir?
Türkçe eklemeli bir dildir. Bir köke birçok ek gelebilir ve kelimeler uzar. Bu yüzden aynı anlamı taşıyan bir Türkçe cümle, İngilizce karşılığına göre çoğu tokenizer’da daha fazla token tutabilir. Fark, kullanılan modele ve metne göre değişir; sabit bir oran yoktur. Kesin sayıyı görmek için kullandığınız modelin tokenizer aracında kendi metninizi denemeniz gerekir.
Pratik sonucu şu: uzun içerikler, ayrıntılı prompt’lar veya doküman analizi yaparken token sayısı hızla artabilir. Daha fazla token hem maliyeti yükseltir hem de bağlam penceresini daha çabuk doldurur. Kısa, net ve yapılandırılmış yazmak bu yüzden hem performansı hem maliyeti olumlu etkiler.
Model Anlamı Nasıl Çözer?
Aynı token farklı anlamlar taşıyabilir. “Yüz” kelimesi yüz lira, denizde yüzmek veya insan yüzü anlamına gelebilir. Modern dil modelleri bu farkı genel olarak dikkat (attention) mekanizması sayesinde çözer: her token, çevresindeki token’lara bakarak kendi anlamını şekillendirir.
Bu mekanizmayı kavramak, modelin neden bazen bağlamı doğru yakalayıp bazen şaştığını anlamanıza yardımcı olur. Prompt’a net bağlam eklemek, modelin doğru yorum yapma ihtimalini artırır.
Token Nedir Sorusundan Context Window’a: Model Neden Unutur?
Modelin aynı anda görebildiği ve işleyebildiği token sayısına bağlam penceresi (context window) denir. Bunu bir masa gibi düşünebilirsiniz. Masanın büyüklüğü, modelin aynı anda önünde tutabileceği bilgi miktarını belirler. Pencere dolduğunda, uygulamanın nasıl tasarlandığına göre eski bilgiler dışarıda kalabilir veya özetlenebilir. Bu yüzden çok uzun sohbetlerde model, başta söylediğiniz ayrıntıları kaçırabilir.
2026’da bağlam penceresi büyüdü. Örneğin The Batch’in aktardığına göre Eylül 2026’da duyurulan Claude Opus 5.5, 1 milyon token’a kadar girdi kabul ediyor. Ama pencerenin büyük olması, modelin her bilgiyi aynı doğrulukla kullanacağı anlamına gelmez. Uzun bağlamı verimli kullanmak ayrı bir beceridir.
Token Nedir Sorusunun Pratik Etkileri
- Maliyet: API kullanımında faturalandırma token üzerinden yapılır. Hem gönderdiğiniz prompt hem gelen yanıt token olarak hesaplanır. Örneğin yukarıda anılan Opus 5.5 için milyon token başına 4 dolar girdi, 20 dolar çıktı fiyatı duyuruldu. Fiyatlar modele göre değişir.
- Yanıtın akışı: Model yanıtı token token üretir. Bu yüzden cevap ekrana yavaş yavaş akar.
- Optimizasyon: Gereksiz uzun talimatlar, tekrarlar ve aşırı ayrıntı token israfına yol açar. Net ve yapılandırılmış prompt’lar hem daha iyi sonuç verir hem daha az token harcar.
- Uzun içerikler: Büyük bir metni doğrudan modele vermek yerine parçalara bölmek veya önce özetletmek çoğu zaman daha verimlidir.
Yapay Zeka Eğitiminde Token Mantığını Öğrenmenin Faydası
Token nedir sorusuna net bir cevap bulmak ve yapay zeka eğitiminde token kavramını erken dönemde anlamak, ileride karşılaşacağınız birçok sorunu önceden çözmenizi sağlar. Prompt yazarken bazı kelimelerin neden daha fazla token harcadığını, modelin uzun sohbetlerde başı neden kaçırdığını ve maliyetlerin neden değişken olduğunu bilirsiniz.
Bu bilgi hem bireysel kullanımlarda hem profesyonel projelerde daha bilinçli hareket etmenizi sağlar. Token mantığı oturduğunda yapay zeka ile çalışmak hem daha öngörülebilir hem daha verimli hale gelir.
Özetle, token nedir diye soranlara kısa cevap şudur: token, yapay zekânın metni parçalara ayırma ve işleme yöntemidir. Model kelime kelime değil, parça parça okur ve cevap verir. Türkçe gibi eklemeli dillerde bu parçalar çoğu zaman daha küçük ve daha çok olur. Bağlam penceresi ise modelin aynı anda önünde tutabildiği token miktarını belirler.
Token mantığını öğrendikten sonra asıl fark, bu bilgiyi gerçek işlerde ve projelerde kullanabilmekte ortaya çıkar. Yapay Zeka’yı sadece denemek değil, dijital pazarlama, içerik üretimi, müşteri iletişimi ve performans odaklı çalışmalara entegre etmek istiyorsanız, sistemli bir eğitim süreci büyük kolaylık sağlar.
Sosyal Medya Kampüsü’nün Yapay Zeka eğitimlerinde bu konuları adım adım, uygulamalı olarak ele alıyoruz. Prompt mühendisliğinden token optimizasyonuna, uzun bağlam yönetimine ve gerçek kampanya örneklerine kadar hem teknik hem de pratik tarafta ilerleyebilirsiniz. İster bireysel olarak kendinizi geliştirmek, ister ekibinizi güncel tutmak isteyin, güncel programlara göz atarak size uygun eğitimleri inceleyebilirsiniz.
Sık Sorulan Sorular
Token nedir?
Token, yapay zekâ modelinin metni işlerken kullandığı en küçük birimdir. Bir token bazen tam bir kelime, bazen bir hece veya ek, bazen de noktalama işareti olabilir. Model metni kelimelerle değil, bu parçalara karşılık gelen sayılarla işler. Parçalara ayırma biçimi her modelin kendi tokenizer’ına göre değişir.
Bir kelime kaç token eder?
Sabit bir cevap yok. Sık kullanılan kısa kelimeler çoğu zaman tek token olur, uzun veya nadir kelimeler birkaç parçaya bölünür. Türkçe gibi eklemeli dillerde kelimeler daha çok parçalanabilir. Kesin sayıyı görmek için kullandığınız modelin tokenizer aracında kendi metninizi denemeniz en güvenilir yoldur.
Türkçe metinler neden daha fazla token harcayabilir?
Token nedir bilenler için bu şaşırtıcı değil: Türkçe eklemeli bir dildir; bir köke çok sayıda ek gelir ve kelimeler uzar. Birçok tokenizer bu uzun kelimeleri daha küçük ve daha çok parçaya böler. Bu yüzden aynı anlamdaki Türkçe cümle, İngilizce karşılığından çoğu zaman daha fazla token tutar. Fark modele ve metne göre değişir.
Context window (bağlam penceresi) nedir?
Context window, modelin aynı anda görebildiği ve işleyebildiği token miktarıdır. Hem sizin yazdıklarınız hem modelin cevapları bu pencereye sığmalıdır. Pencere dolduğunda eski bilgiler dışarıda kalabilir, bu yüzden uzun sohbetlerde model başta söylediklerinizi kaçırabilir. Büyük pencere, her bilginin eşit iyi kullanılacağını garanti etmez.
Token sayısı maliyeti nasıl etkiler?
API üzerinden kullanımda ücretlendirme token başına yapılır. Gönderdiğiniz prompt ve modelin ürettiği cevap ayrı ayrı sayılır, çıktı token’ı genellikle girdiden pahalıdır. Daha uzun prompt ve daha uzun cevap daha yüksek maliyet demektir. Net ve kısa talimatlar yazmak maliyeti düşürür. Güncel fiyatları ilgili sağlayıcının sayfasından kontrol edin.
Token mantığını bilmek prompt yazarken ne işe yarar?
Token mantığını bilmek, gereksiz tekrar ve ayrıntıyı ayıklamanızı sağlar. Böylece hem maliyeti düşürür hem de modelin bağlam penceresini önemli bilgiye ayırırsınız. Uzun dokümanları parçalara bölmek, net bağlam eklemek ve yapılandırılmış talimat vermek, daha tutarlı cevaplar almanıza yardımcı olur. Token nedir sorusunu bilmek, bu yüzden günlük kullanımda da somut fayda sağlar.